API로 챗봇을 만들어 처음 테스트했을 때, 질문을 보내고 10초 동안 아무 반응이 없다가 답이 한꺼번에 나타났습니다. 답은 좋았지만 사용자는 그 10초 동안 "고장 났나?" 생각했을 겁니다. claude.ai처럼 글자가 흘러나오게 하려면 스트리밍(Streaming)을 써야 합니다.
스트리밍이 필요한 이유
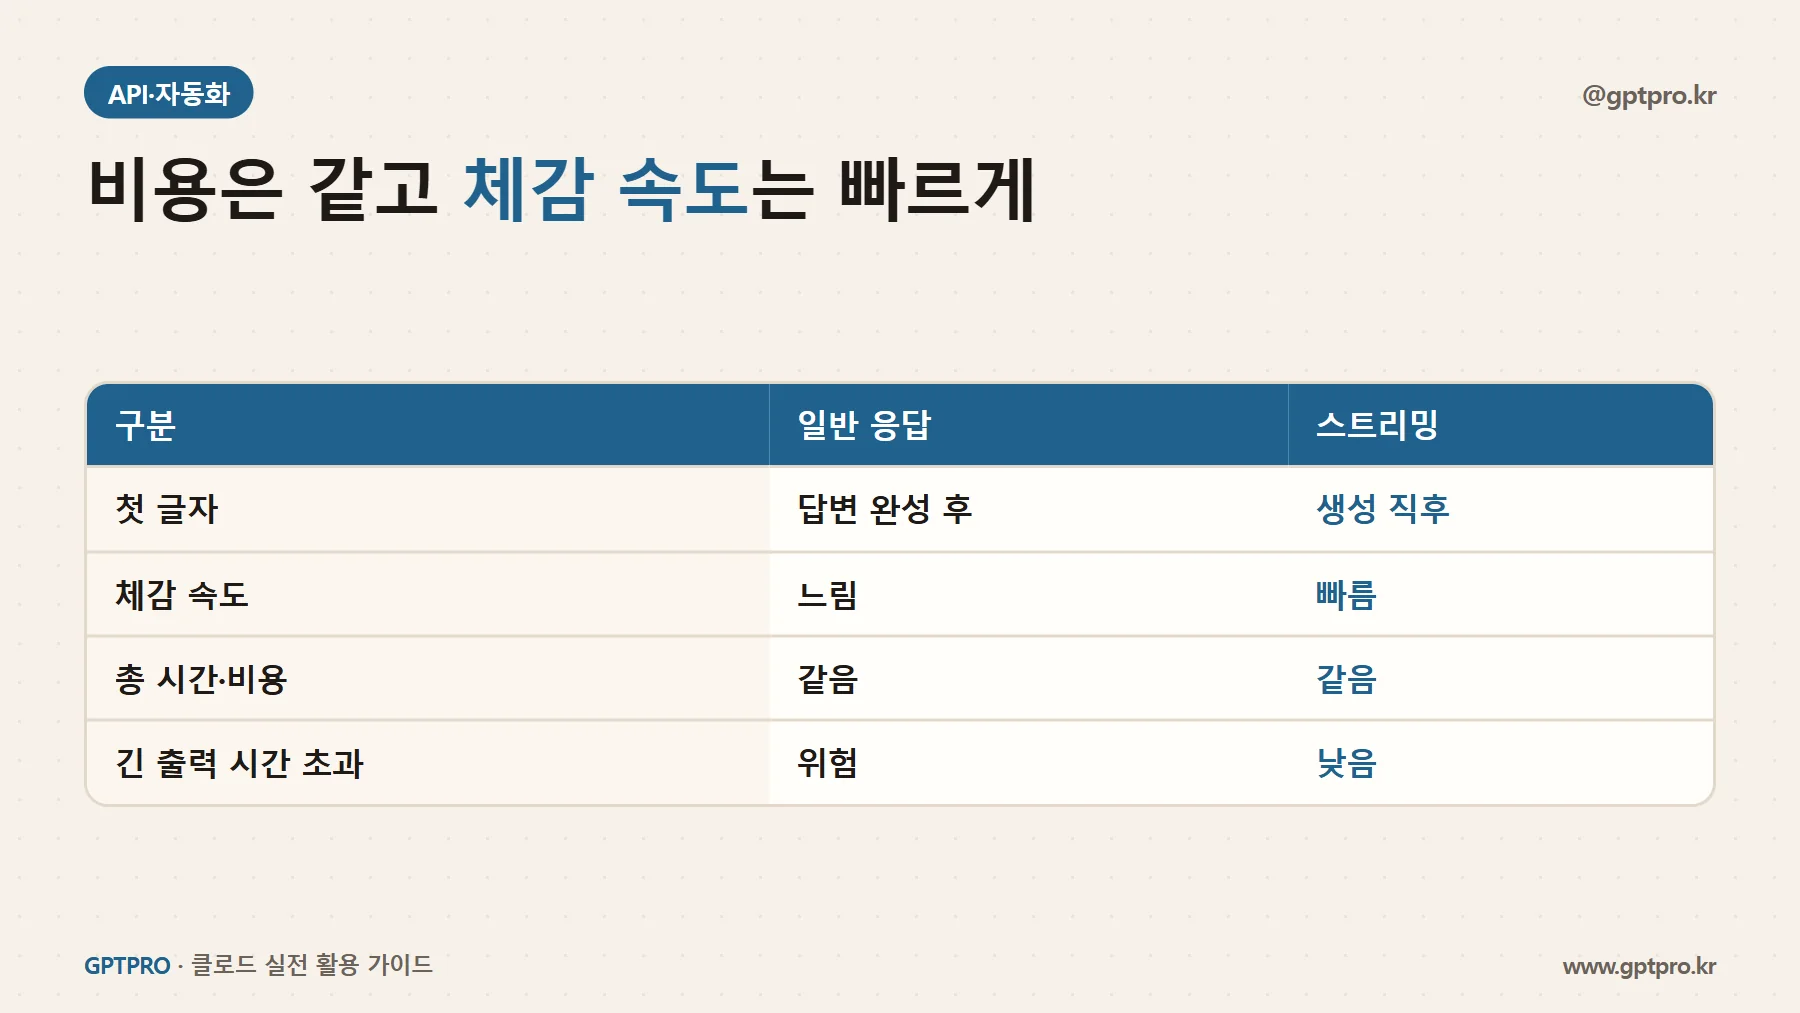
| 구분 | 일반 응답 | 스트리밍 |
|---|---|---|
| 첫 글자가 보이는 시점 | 답변 완성 후 | 생성 시작 직후 |
| 체감 속도 | 느림 | 빠름 |
| 총 소요 시간 | 같음 | 같음 |
| 비용 | 같음 | 같음 |
| 긴 출력의 시간 초과 위험 | 있음 | 낮음 |
총 시간은 같지만 사용자가 기다린다고 느끼는 시간이 크게 줄어듭니다. 그리고 아주 긴 출력을 요청할 때 HTTP 요청 시간 초과를 피하는 데도 스트리밍이 권장됩니다.
파이썬 기본 예제
파이썬 SDK의 messages.stream()을 쓰면 간단합니다.
import anthropic

client = anthropic.Anthropic()

with client.messages.stream(
    model="claude-sonnet-5",
    max_tokens=2048,
    messages=[{"role": "user", "content": "재택근무 생산성을 높이는 습관 5가지를 설명해 줘."}],
) as stream:
    for text in stream.text_stream:
        print(text, end="", flush=True)

print()
text_stream은 생성되는 텍스트 조각을 차례로 내보냅니다. flush=True로 바로바로 출력하면 터미널에서 글자가 흘러나오는 것을 볼 수 있습니다.
최종 메시지와 사용량 받기
스트리밍이 끝난 뒤 완성된 메시지 전체와 토큰 사용량이 필요할 때가 많습니다.
with client.messages.stream(
    model="claude-sonnet-5",
    max_tokens=2048,
    messages=messages,
) as stream:
    for text in stream.text_stream:
        send_to_client(text)          # 화면으로 조각 전달
    final = stream.get_final_message()  # 완성된 메시지

print(final.stop_reason)
print(final.usage.input_tokens, final.usage.output_tokens)
get_final_message()로 받은 메시지는 대화 기록에 저장하거나 비용을 집계하는 데 씁니다. 화면에 조각을 보여 주는 일과 기록 저장을 이렇게 나누면 깔끔합니다.
웹 서비스로 전달하는 구조
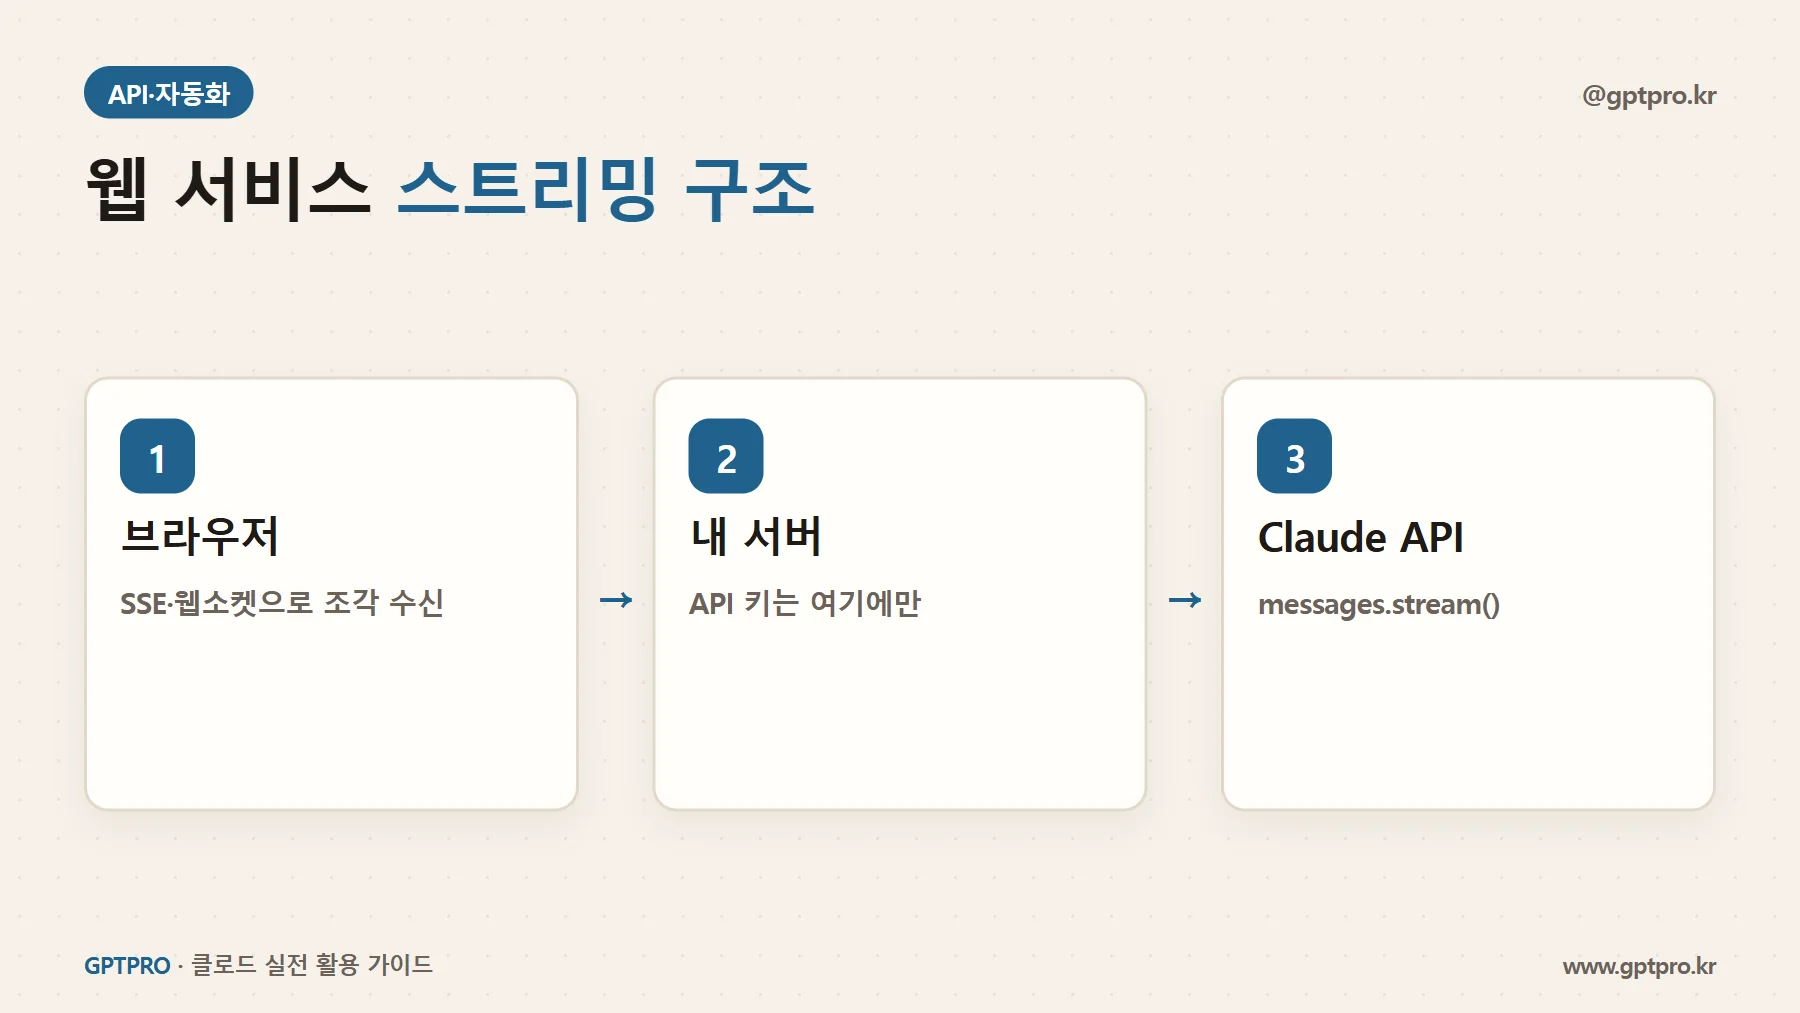
실제 챗봇에서는 서버가 클로드로부터 받은 조각을 다시 브라우저로 흘려 보내야 합니다.
브라우저 ⇄ 내 서버 ⇄ Claude API
         (SSE 등)     (stream)
- 서버 → 브라우저: Server-Sent Events(SSE)나 웹소켓으로 조각을 전달합니다.
- API 키는 서버에만: 브라우저에서 직접 Claude API를 호출하면 키가 노출됩니다. 반드시 서버를 거치세요.
이벤트 단위로 다루기
텍스트 외에 툴 호출이나 생각(thinking) 블록 등을 함께 다루는 고급 기능에서는 텍스트 조각 대신 이벤트 단위로 처리합니다. 메시지 시작, 콘텐츠 블록 시작·변경·종료, 메시지 종료 같은 이벤트가 순서대로 옵니다. 처음에는 text_stream으로 충분하고, 툴 사용 같은 기능을 붙일 때 이벤트 처리를 공부하면 됩니다.
주의할 점
- 중간 끊김 처리: 네트워크 오류로 스트림이 끊기면 화면에 상태를 알리고 재시도 버튼을 제공하세요.
- stop_reason 확인:
max_tokens로 끊긴 경우 답이 중간에 잘린 것이니, 사용자에게 알리거나 이어서 생성하게 합니다. - 화면 렌더링 부하: 조각마다 화면 전체를 다시 그리면 느려집니다. 일정 간격으로 묶어 갱신하세요.
- 마크다운 렌더링: 표나 코드 블록은 완성되기 전까지 깨져 보일 수 있습니다. 렌더링 라이브러리가 부분 마크다운을 처리하는지 확인하세요.
💬 체감 속도가 사용자 경험입니다
스트리밍을 적용하기 전과 후, 같은 챗봇에 대한 테스트 사용자들의 반응이 확연히 달랐습니다. 응답 시간은 똑같은데 "빨라졌다"는 말을 들었습니다. 사용자 경험에서는 실제 속도만큼 체감 속도가 중요하다는 걸 배웠습니다. 사용자가 화면 앞에서 기다리는 서비스라면, 스트리밍은 선택이 아니라 기본으로 생각하세요.
이 글의 요점
- 스트리밍은 비용 변화 없이 체감 속도를 높이고, 긴 출력의 시간 초과 위험을 줄입니다.
- 파이썬 SDK의
messages.stream()과text_stream으로 간단히 구현합니다. get_final_message()로 완성 메시지와 사용량을 받고, 끊김·잘림 처리를 준비하세요.