글쓰기 비교에 이어 이번에는 코딩입니다. 실제로 이 블로그 스크립트를 만들며 겪었던 유형의 버그 세 개를 재구성해, 클로드와 챗GPT 대화창에 같은 방식으로 질문했습니다.
📌 작성 시점 두 서비스의 유료 플랜 기본 모델, 대화창 기준입니다. 모델 업데이트에 따라 결과는 달라질 수 있습니다.
테스트 방법
- 버그가 있는 코드와 에러 메시지(또는 잘못된 결과)를 그대로 붙여 넣음
- 질문은 동일: "이 코드의 문제를 찾고 고쳐 줘. 원인도 설명해 줘."
- 평가: 원인 진단 정확도, 수정 코드 동작, 설명의 유용성, 불필요한 변경 여부
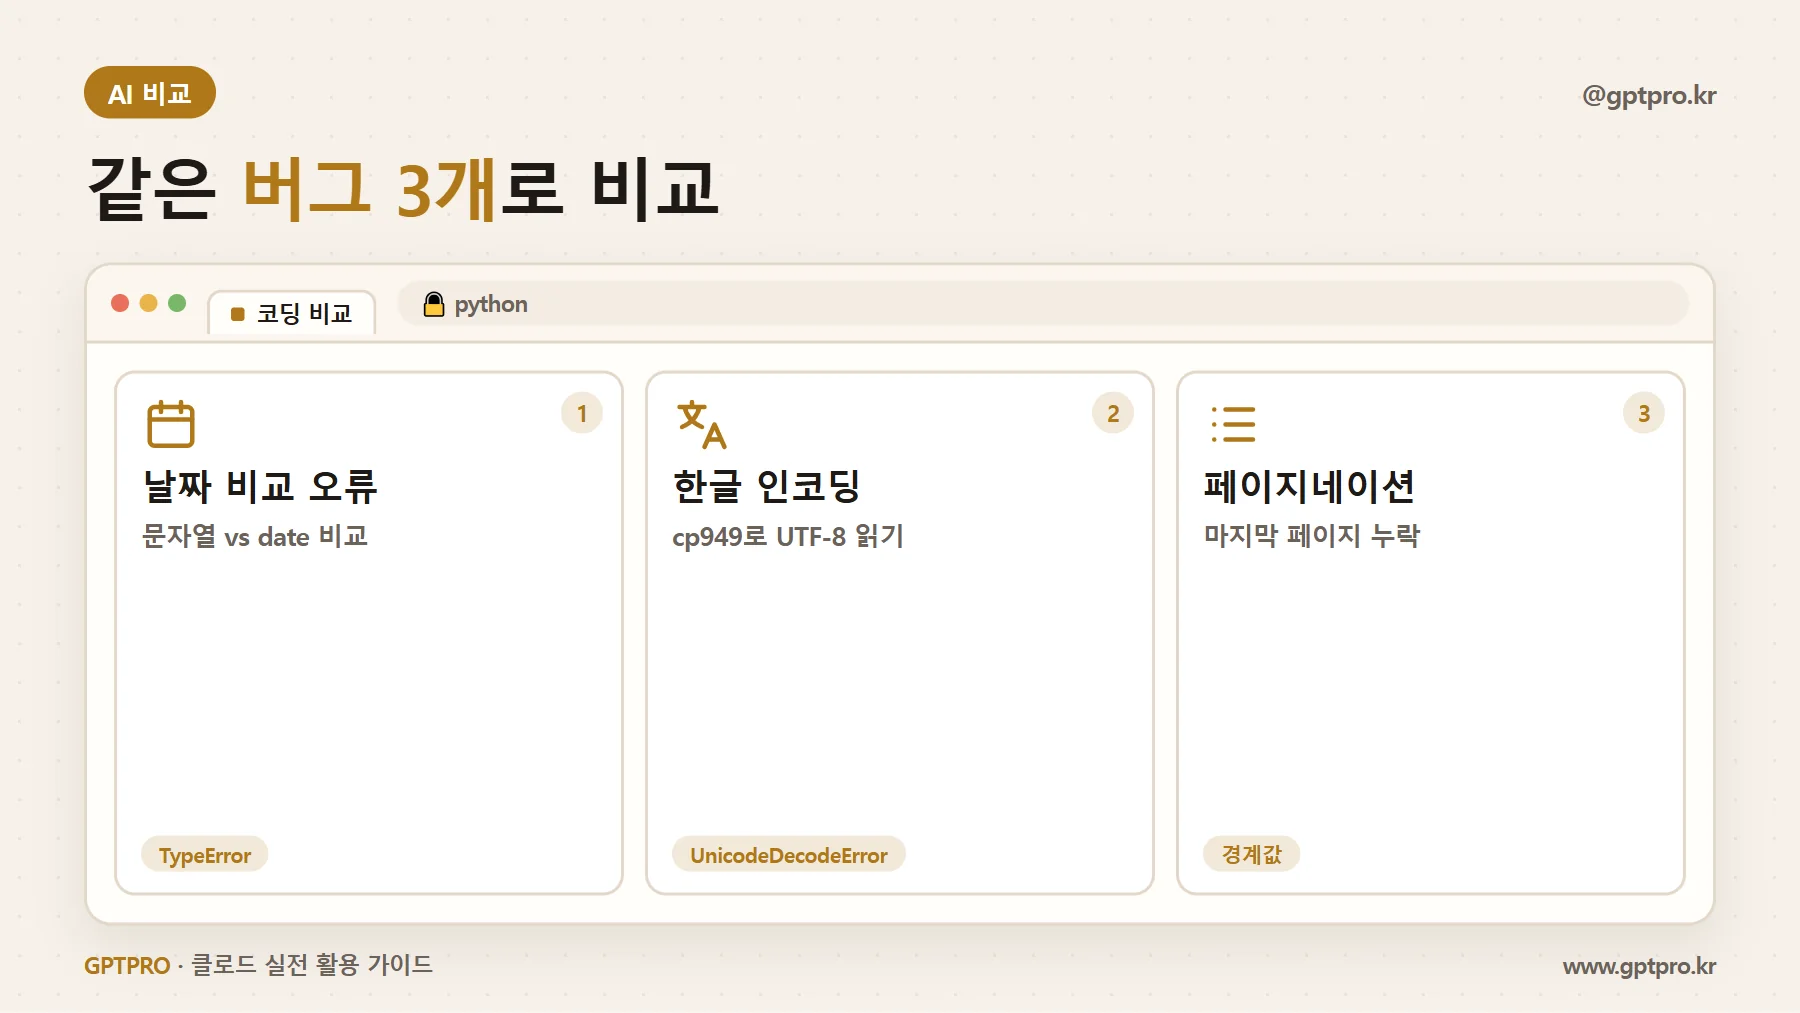
버그 1. 날짜 비교 오류
posts = [{"title": "A", "date": "2026-09-05"}, {"title": "B", "date": "2026-09-10"}]
today = datetime.date.today()
published = [p for p in posts if p["date"] <= today]
# TypeError: '<=' not supported between instances of 'str' and 'datetime.date'
- 클로드: 문자열과 날짜 객체를 비교한 것이 원인이라고 짚고,
date.fromisoformat()으로 변환하는 수정안을 제시. 추가로 시간이 포함된 날짜 문자열이 섞일 경우를 대비한 처리도 제안. - 챗GPT: 같은 원인을 짚고
datetime.strptime으로 변환하는 수정안 제시. 정확하고 간결.
→ 둘 다 정답. 클로드가 데이터 형식이 섞일 가능성까지 언급한 점이 실무적으로 도움이 됐습니다.
버그 2. 윈도우 한글 인코딩
with open("posts.csv") as f:
    rows = f.readlines()
# UnicodeDecodeError: 'cp949' codec can't decode byte ...
- 클로드: 윈도우 기본 인코딩(cp949)으로 UTF-8 파일을 읽어서 생긴 문제라고 설명,
encoding="utf-8"지정. BOM이 있는 파일이면utf-8-sig를 쓰라는 조언 추가. - 챗GPT: 같은 원인과 수정. 인코딩 자동 감지 라이브러리 사용도 대안으로 제시.
→ 둘 다 정답. 대안 제시 방향이 달랐습니다.
버그 3. 페이지네이션 경계값
def paginate(items, per_page):
    total_pages = len(items) // per_page
    return [items[i*per_page:(i+1)*per_page] for i in range(total_pages)]
# 25개, per_page=10 → 마지막 5개가 사라짐
- 클로드: 나머지가 있을 때 마지막 페이지가 빠지는 것을 짚고 올림 나눗셈으로 수정. 항목이 0개일 때 페이지가 0개가 되는데 이것이 의도인지 확인하라고 질문.
- 챗GPT: 같은 원인을 짚고
math.ceil로 수정. 테스트 예시 코드 추가.
→ 둘 다 정답. 클로드는 빈 목록 경계값을, 챗GPT는 테스트 코드를 덧붙였습니다.
종합
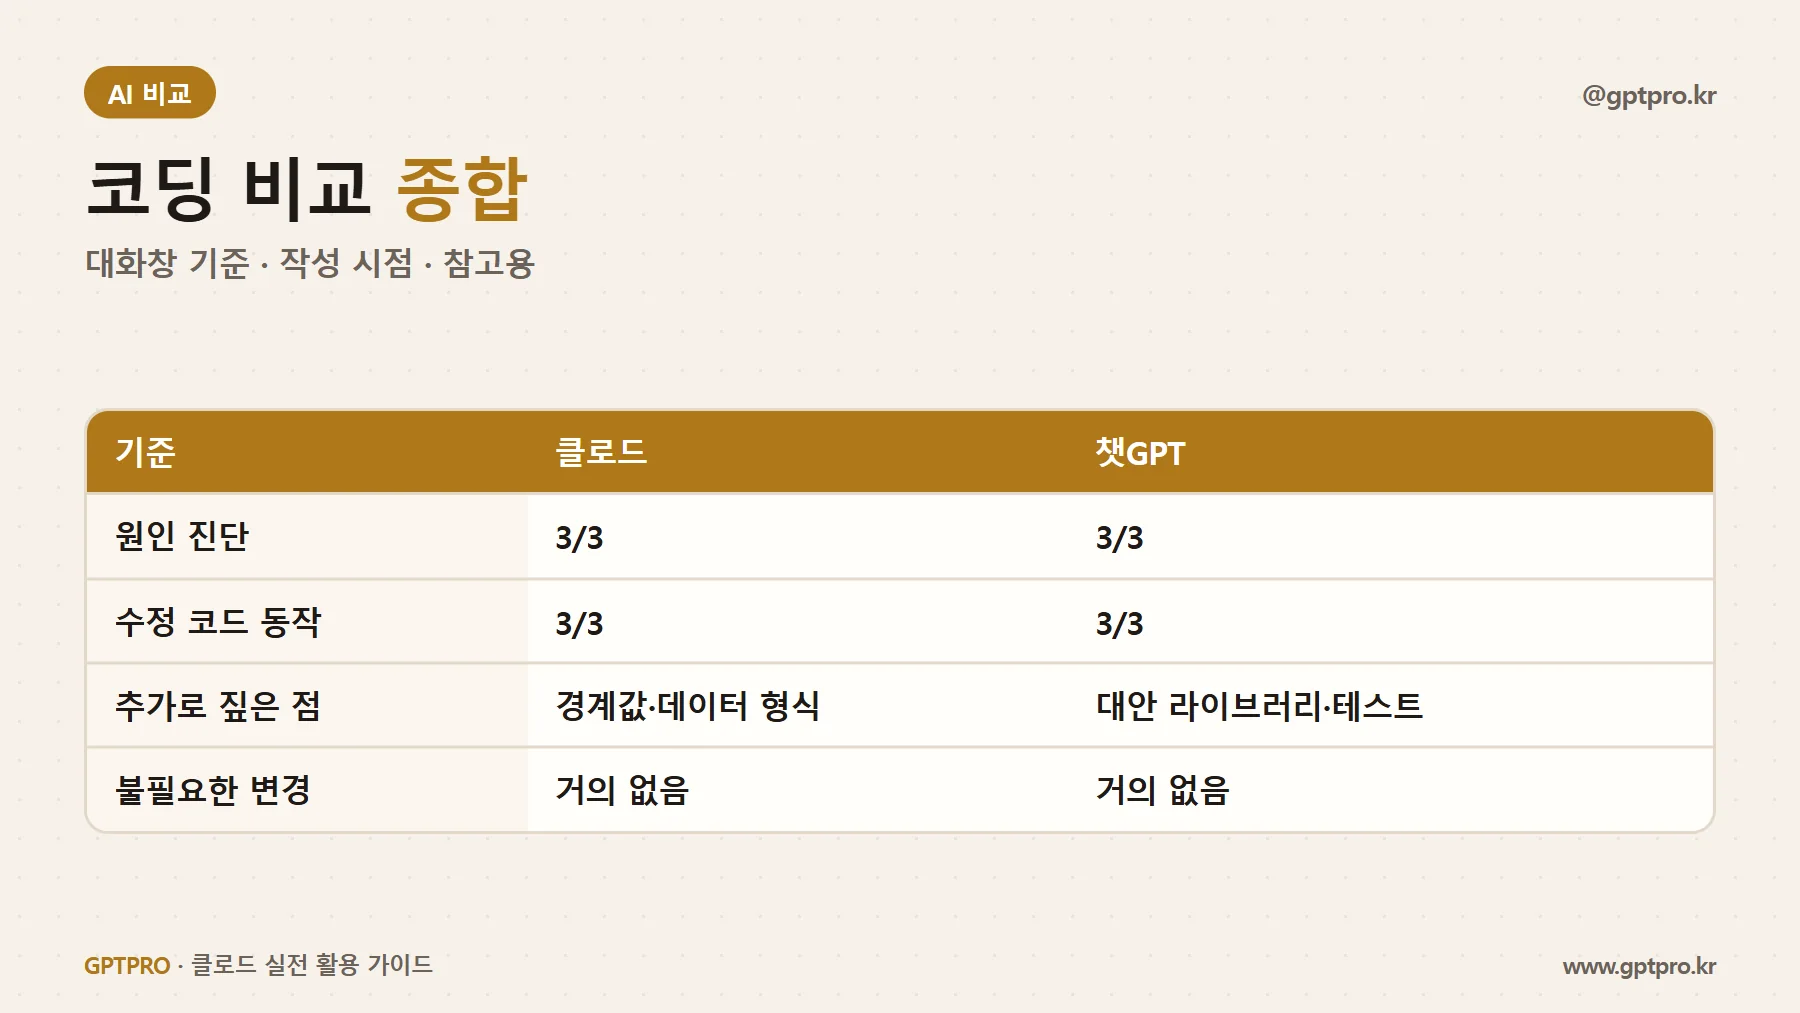
| 기준 | 클로드 | 챗GPT |
|---|---|---|
| 원인 진단 | 3/3 | 3/3 |
| 수정 코드 동작 | 3/3 | 3/3 |
| 추가 위험 언급 | 경계값·데이터 형식 등 | 대안 라이브러리·테스트 |
| 불필요한 변경 | 거의 없음 | 거의 없음 |
결론적으로 단일 코드 조각 수준에서는 큰 차이가 없었습니다. 성향 차이 정도입니다. 클로드는 "이런 경우는 어떻게 할 건지" 되묻는 편이고, 챗GPT는 대안과 예시를 더 붙이는 편이었습니다.
실제 프로젝트에서 차이가 나는 부분
코드 조각 비교보다 실제 생산성에 더 큰 영향을 준 건 도구의 작업 방식이었습니다.
- 파일 여러 개를 읽어야 원인을 찾을 수 있는 버그
- 수정 후 테스트를 돌려 확인해야 하는 작업
- 프로젝트 규칙(CLAUDE.md 등)을 지켜야 하는 작업
이런 작업에서는 대화창보다 클로드 코드 같은 에이전트형 도구가 훨씬 효율적이었습니다. 다른 AI 코딩 도구와의 비교는 AI 코딩 도구 비교에서 정리했습니다.
도구보다 버그 설명법
이번 비교로 확인한 것은, 흔한 버그 수준에서는 어떤 AI를 쓰느냐보다 버그를 어떻게 설명하느냐가 더 중요하다는 점입니다. 에러 메시지 전문, 입력 데이터 예시, 기대 결과를 함께 주면 둘 다 정확하게 답합니다. 반대로 "안 돼요"만 쓰면 둘 다 헤맵니다. 도구를 고르기 전에 질문하는 법부터 점검해 보세요.
핵심 요약
- 같은 버그 3개에서 두 서비스 모두 원인 진단과 수정에 성공했습니다.
- 클로드는 경계값·데이터 형식 위험을 되묻고, 챗GPT는 대안과 테스트 예시를 덧붙이는 성향이었습니다.
- 실제 프로젝트에서는 모델보다 에이전트형 도구 사용 여부와 질문 방식이 더 큰 차이를 만듭니다.