Claude API로 첫 호출을 성공한 뒤 실제 서비스에 붙이면, 언젠가는 오류를 만납니다. 사용자가 몰리는 시간에 요청 한도에 걸리기도 하고, 서버가 일시적으로 바쁠 때도 있습니다. 중요한 건 오류가 나지 않게 하는 것이 아니라 오류가 나도 서비스가 무너지지 않게 하는 것입니다.
오류 종류와 대응
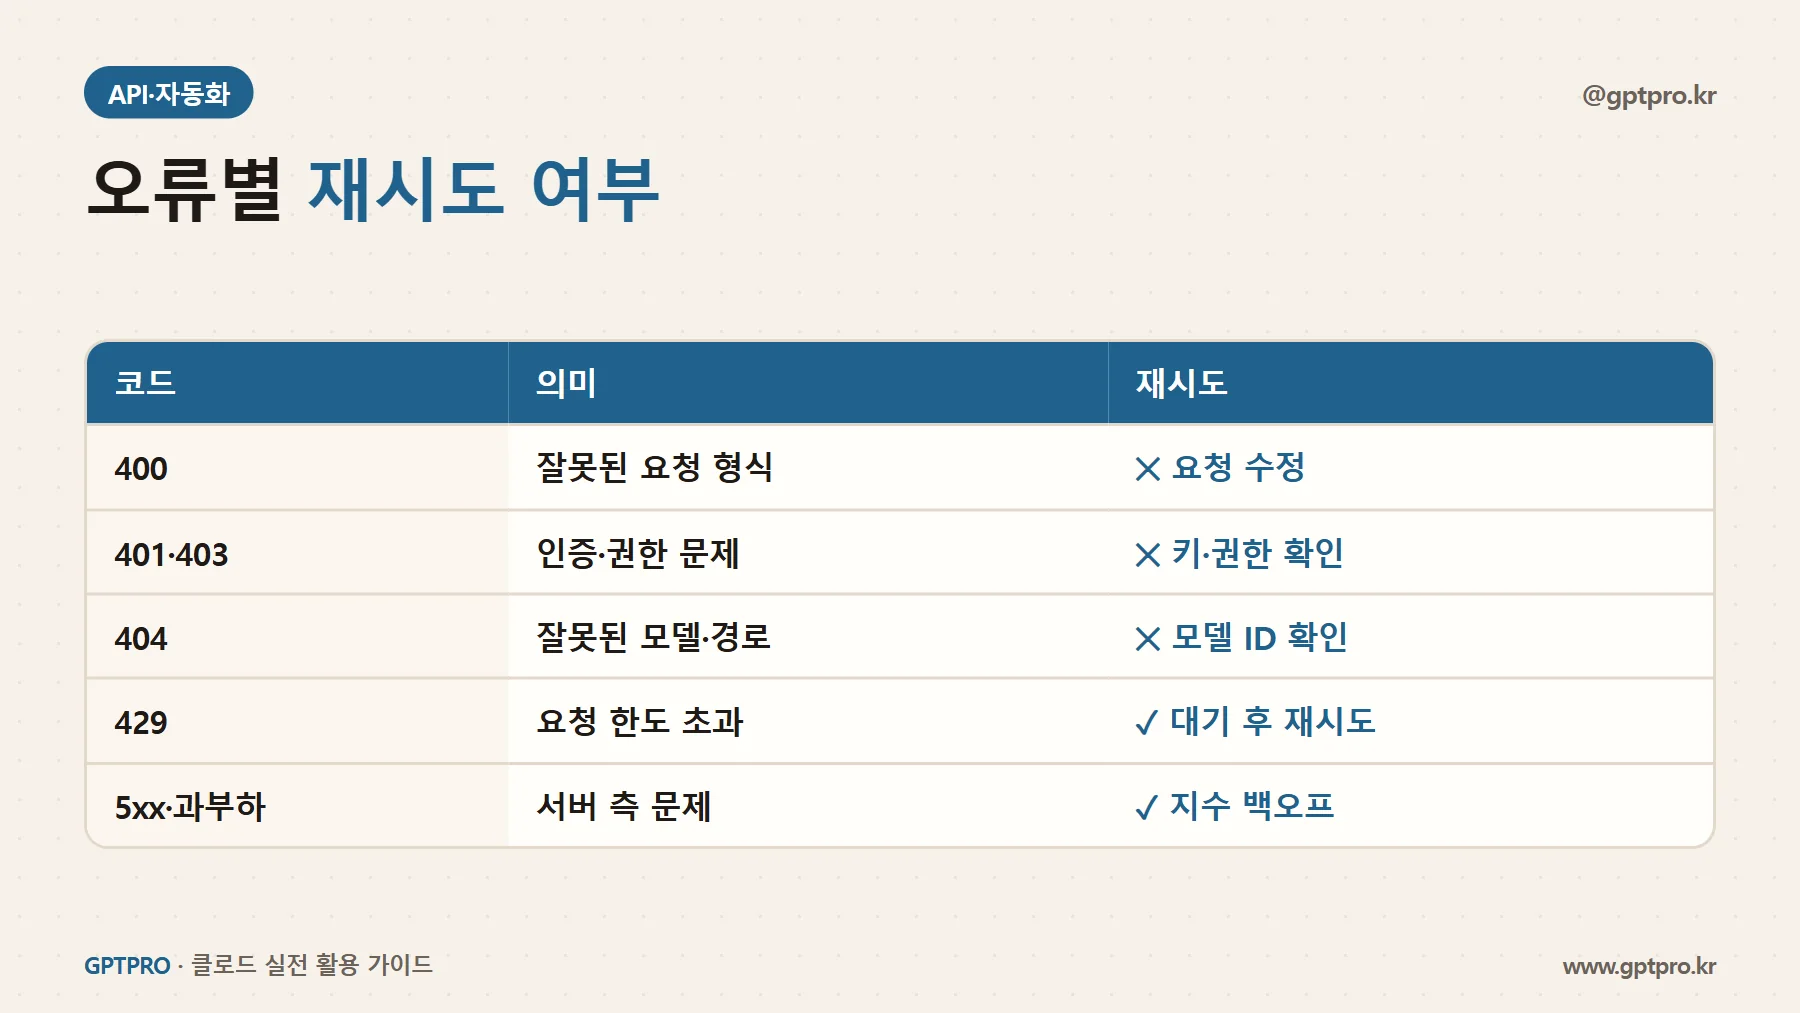
오류는 크게 두 종류로 나뉩니다.
- 고쳐야 하는 오류 (재시도 무의미): 400 잘못된 요청, 401 인증 실패, 403 권한 없음, 404 잘못된 모델 ID. 같은 요청을 다시 보내도 같은 결과입니다.
- 기다리면 되는 오류 (재시도 대상): 429 요청 한도 초과, 5xx 서버 오류, 과부하, 연결 끊김. 잠시 뒤 다시 보내면 성공할 가능성이 높습니다.
SDK 기본 재시도와 타임아웃
공식 파이썬 SDK는 일시적인 오류에 대해 기본적으로 몇 차례 자동 재시도합니다. 서비스 특성에 맞게 조정할 수 있습니다.
import anthropic

client = anthropic.Anthropic(
    max_retries=4,      # 기본 재시도 횟수 조정
    timeout=60.0,       # 초 단위
)

# 특정 요청만 다르게
client.with_options(timeout=20.0, max_retries=1).messages.create(...)
출력이 긴 요청은 스트리밍으로 바꾸면 타임아웃 위험이 줄어듭니다.
예외를 구체적인 것부터 처리하기
예외를 한 덩어리로 잡으면 고쳐야 할 오류와 기다리면 될 오류를 구분할 수 없습니다.
try:
    response = client.messages.create(model="claude-sonnet-5", max_tokens=1024, messages=messages)
except anthropic.BadRequestError as e:
    log.error("요청 형식 오류, 재시도 안 함: %s", e.message)
    raise
except anthropic.AuthenticationError:
    log.error("API 키 확인 필요")
    raise
except anthropic.RateLimitError as e:
    wait = int(e.response.headers.get("retry-after", "30"))
    log.warning("요청 한도 초과, %s초 후 재시도", wait)
    # 작업 큐에 다시 넣는 등 서비스에 맞게 처리
except anthropic.APIStatusError as e:
    log.warning("서버 오류 %s, 나중에 재시도", e.status_code)
except anthropic.APIConnectionError:
    log.warning("네트워크 오류, 나중에 재시도")
실무 패턴 4가지
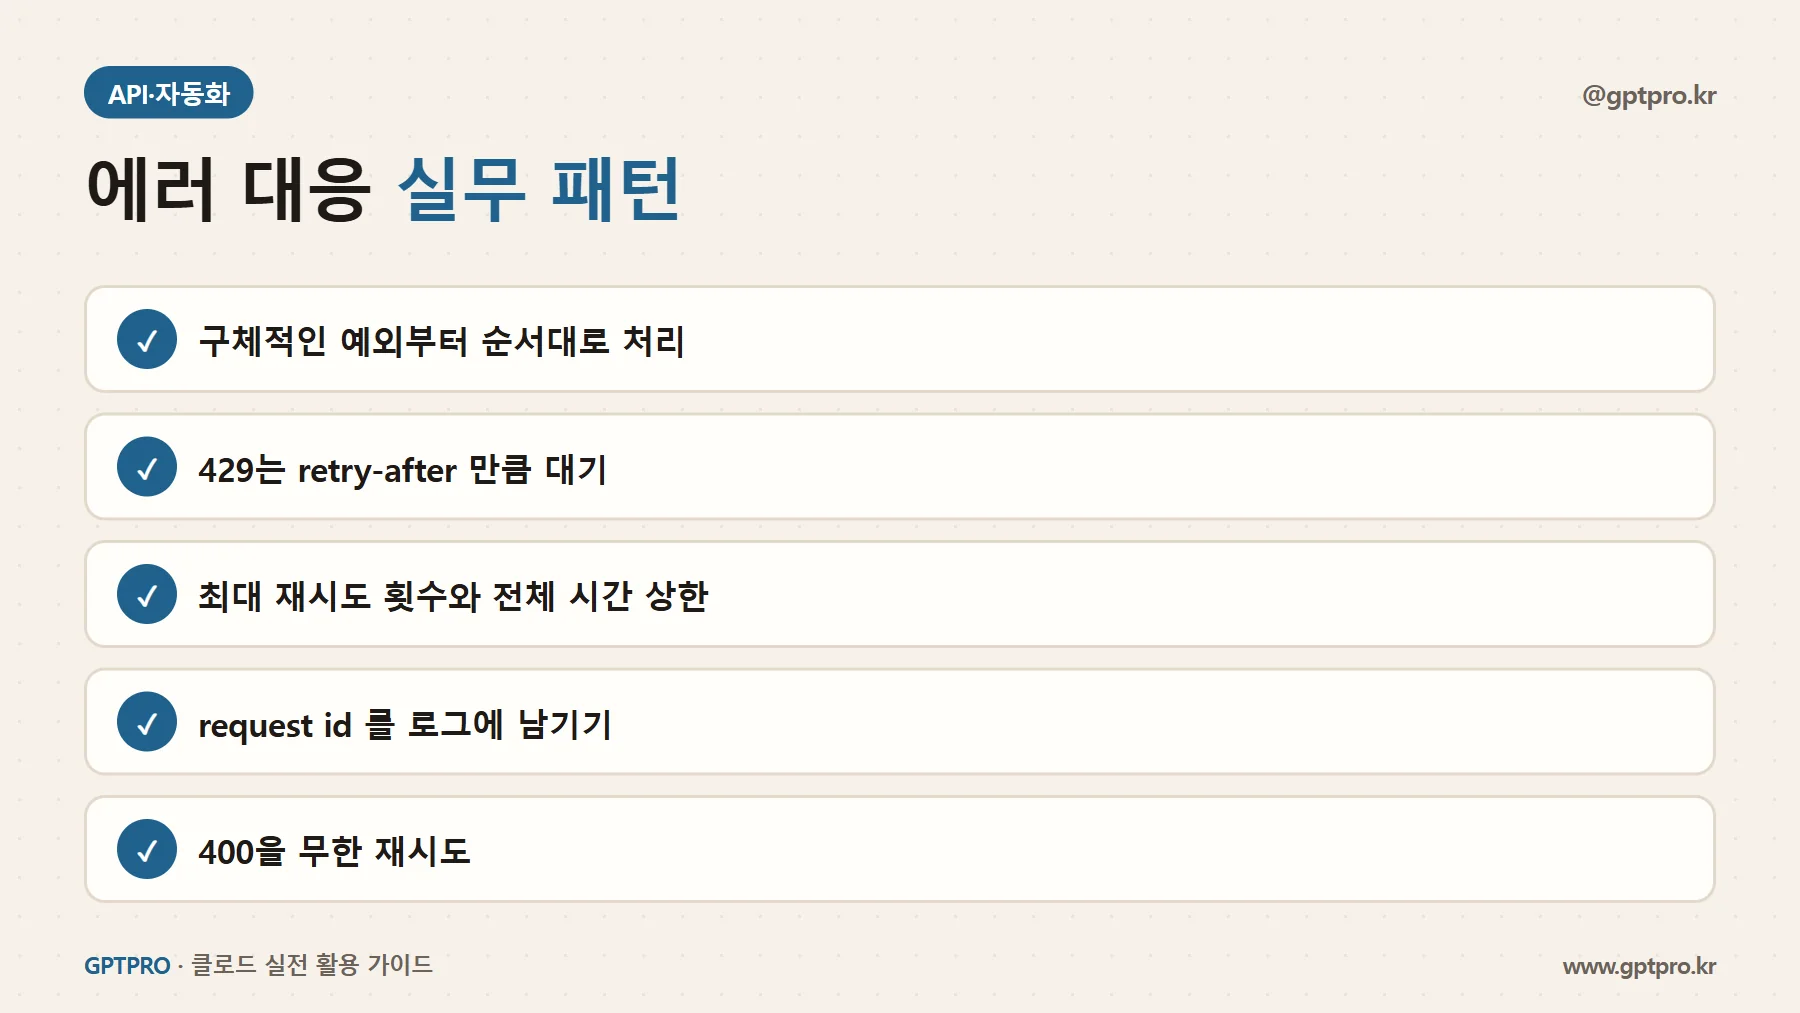
- 구체적인 예외부터: 위 예시처럼 처리 순서를 정합니다.
- 429는 안내된 시간만큼: 응답 헤더의
retry-after를 따릅니다. - 상한 두기: 재시도 횟수와 전체 대기 시간에 상한을 둬서 요청이 영원히 걸려 있지 않게 합니다.
- 로그에 요청 ID: 응답 객체의 요청 ID를 남겨 두면 문제를 문의할 때 추적이 쉽습니다.
사용자 화면에서는
오류 메시지를 그대로 보여 주지 말고, "잠시 후 다시 시도해 주세요" 같은 안내와 다시 시도 버튼을 둡니다. 대량 작업이라면 실패한 건만 모아 나중에 다시 처리하거나, 처음부터 배치 API로 보내는 방법도 있습니다.
운영하며 배운 것
처음 자동화 스크립트를 만들었을 때 모든 예외를 잡아 무조건 재시도하게 했다가, 모델 ID 오타 하나로 같은 요청이 계속 실패하며 로그만 쌓인 적이 있습니다. 그 뒤로는 "고칠 오류는 바로 멈추고, 기다릴 오류만 재시도" 원칙을 지킵니다. 이 구분 하나로 장애 상황이 훨씬 단순해졌습니다.
마무리
- 400·401·403·404는 고쳐야 할 오류, 429·5xx·연결 오류는 재시도 대상입니다.
- SDK의 재시도·타임아웃 설정을 서비스에 맞게 조정하고, 긴 출력은 스트리밍을 쓰세요.
- 예외는 구체적인 것부터 처리하고, 재시도 상한과 요청 ID 로그를 남깁니다.