"연차 이월 규정이 어떻게 되죠?" 인사팀에 하루에도 몇 번씩 들어오는 질문입니다. 답은 규정집에 있지만 120쪽을 뒤지기 싫은 거죠. 이런 질문에 사내 문서를 근거로 답하는 봇을 만드는 기본 구조가 RAG입니다.
두 가지 방식: 통째로 넣기 vs 검색해서 넣기
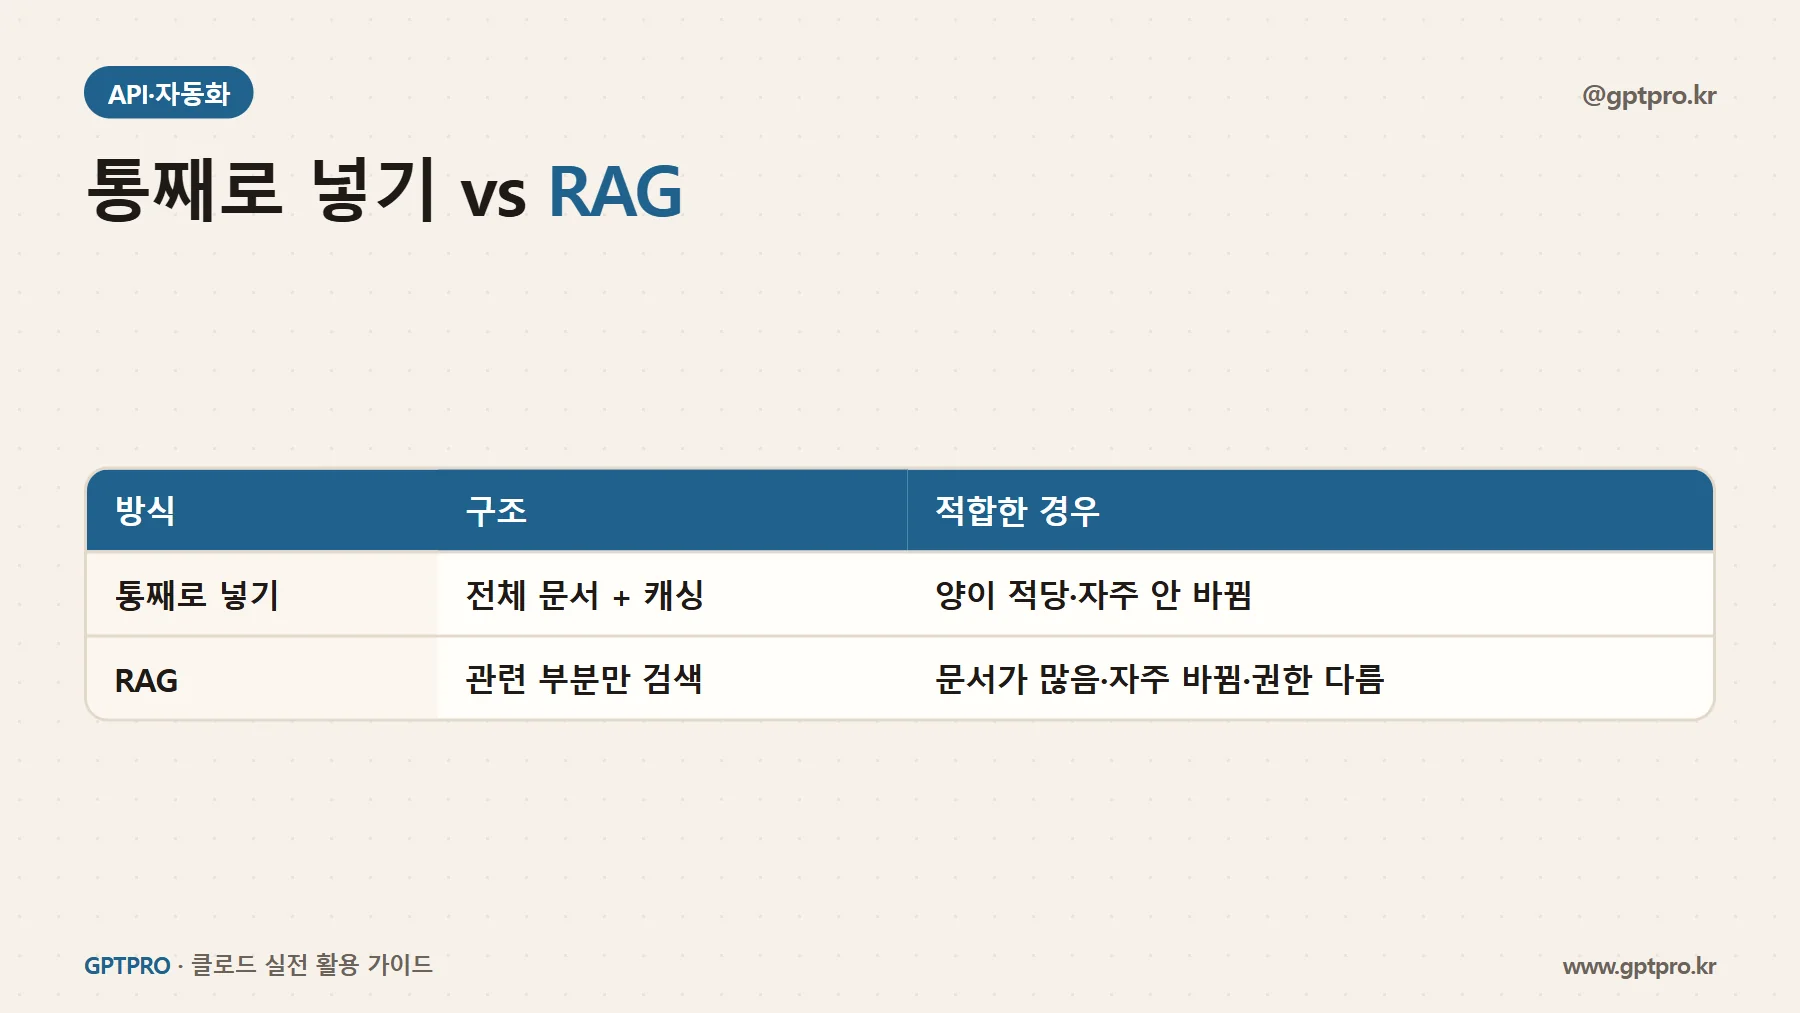
| 방식 | 구조 | 적합한 경우 |
|---|---|---|
| 통째로 넣기 | 모든 문서를 프롬프트에 포함 + 캐싱 | 문서 양이 적당하고 자주 안 바뀜 |
| RAG | 질문과 관련된 부분만 검색해 포함 | 문서가 많거나 자주 바뀜 |
최신 클로드 모델은 컨텍스트가 매우 길어서, 문서가 수백 쪽 이하라면 통째로 넣고 프롬프트 캐싱을 쓰는 방식이 더 간단하고 정확할 수 있습니다. 문서가 그보다 많거나, 매일 바뀌거나, 부서별로 접근 권한이 다르다면 RAG를 고려합니다.
RAG의 3단계
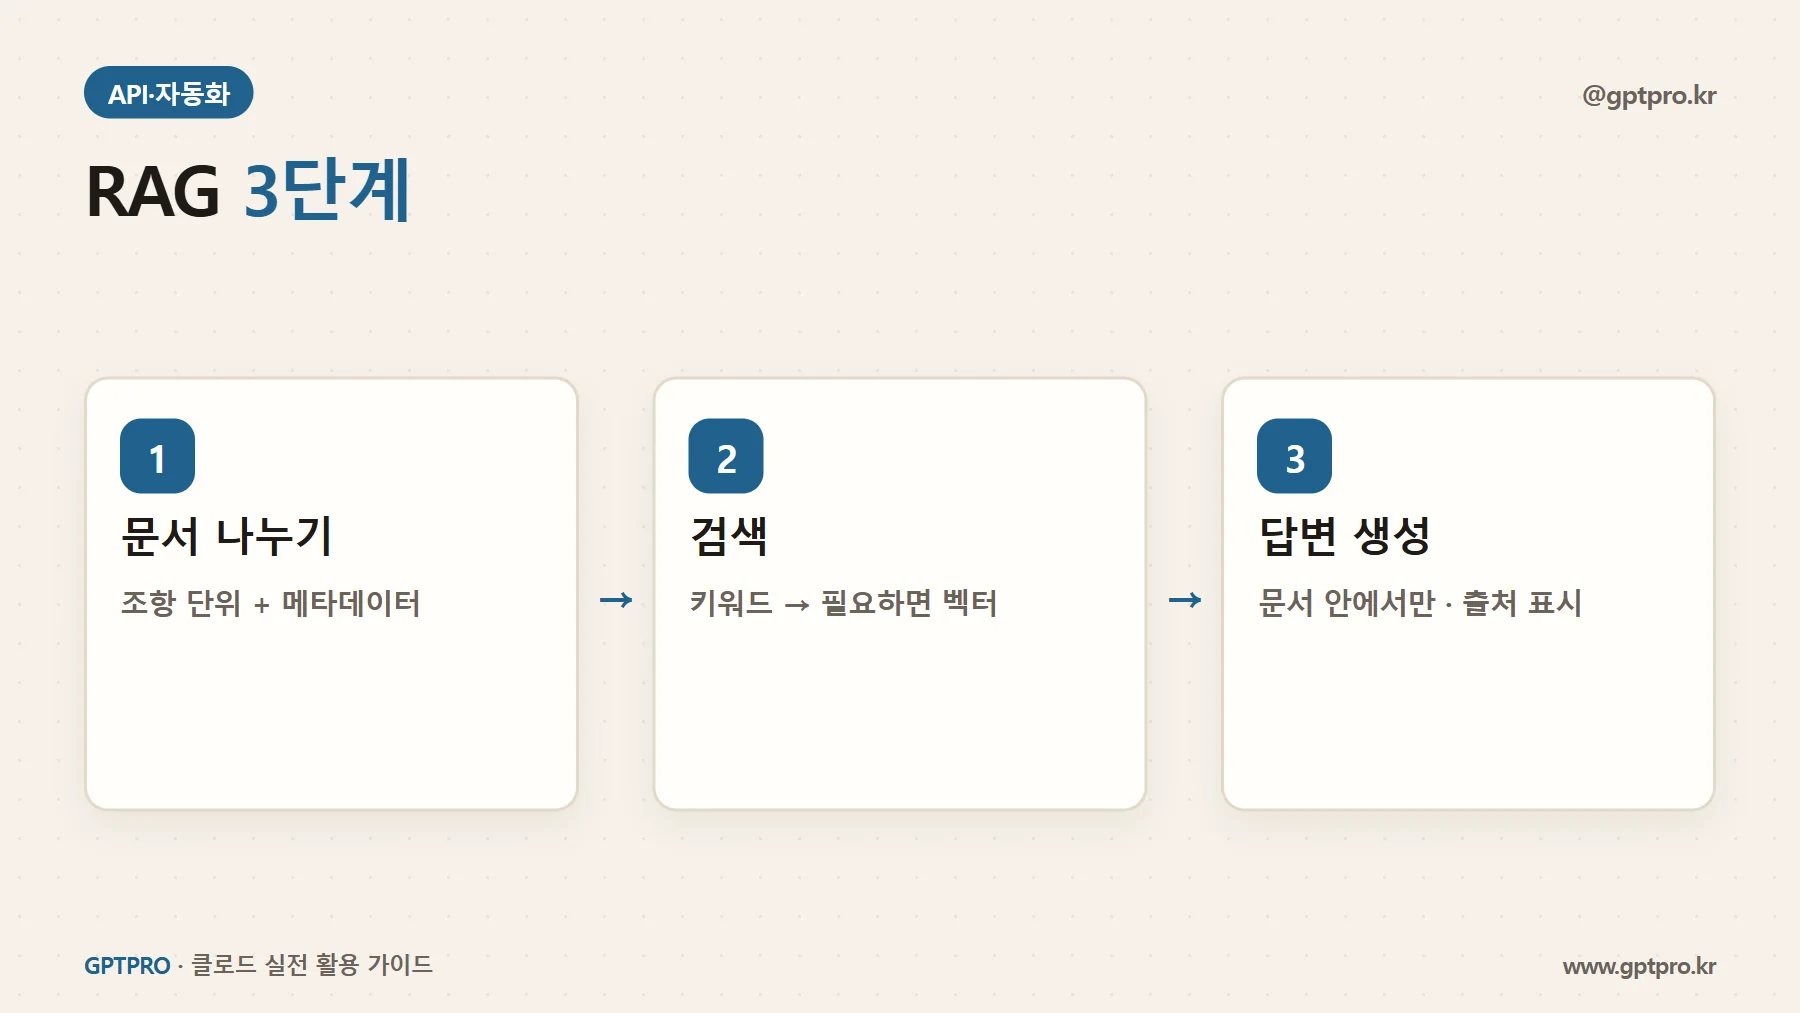
[준비] 문서 → 조각(chunk)으로 나누기 → 검색 색인 만들기
[질문 시]
  1. 검색: 질문과 관련된 조각 찾기
  2. 조립: 찾은 조각을 프롬프트에 넣기
  3. 생성: 클로드가 조각을 근거로 답하기
1. 문서 나누기
긴 문서를 검색 가능한 크기로 나눕니다.
- 의미 단위로: 조항, 섹션 단위로 나누는 것이 글자 수로 자르는 것보다 좋습니다.
- 메타데이터 붙이기: 각 조각에 문서명, 조항 번호, 개정일을 붙여 두면 출처를 표시할 수 있습니다.
- 약간 겹치게: 조각 경계에서 문맥이 끊기지 않도록 앞뒤를 조금 겹치기도 합니다.
2. 검색
| 검색 방식 | 특징 |
|---|---|
| 키워드 검색 | 단어가 일치하는 조각을 찾음. 단순하고 빠름 |
| 벡터(임베딩) 검색 | 의미가 비슷한 조각을 찾음. "휴가"로 "연차"를 찾을 수 있음 |
| 하이브리드 | 둘을 함께 사용 |
작은 규모라면 키워드 검색으로 시작하고, "단어는 다른데 뜻은 같은" 질문에서 실패가 잦을 때 벡터 검색을 추가하는 순서를 권합니다.
3. 답변 생성 (파이썬 예시)
검색은 이미 구현했다고 가정하고, 찾은 조각으로 답하는 부분입니다.
import anthropic

client = anthropic.Anthropic()

SYSTEM = """너는 사내 규정 안내 도우미다.
- <documents> 안의 내용만 근거로 답한다. 문서에 없으면 "규정에서 찾을 수 없습니다. 인사팀에 문의해 주세요."라고 답한다.
- 답변 끝에 근거가 된 문서명과 조항 번호를 표시한다.
- 규정 해석이 애매하면 단정하지 말고 담당 부서 확인을 권한다."""

def answer(question: str, chunks: list[dict]) -> str:
    docs = "\n".join(
        f'<document source="{c["source"]}" section="{c["section"]}">\n{c["text"]}\n</document>'
        for c in chunks
    )
    response = client.messages.create(
        model="claude-sonnet-5",
        max_tokens=1024,
        system=SYSTEM,
        messages=[{
            "role": "user",
            "content": f"<documents>\n{docs}\n</documents>\n\n질문: {question}",
        }],
    )
    return "".join(b.text for b in response.content if b.type == "text")

chunks = search("연차 이월 규정", top_k=5)  # 직접 구현한 검색 함수
print(answer("연차를 다음 해로 이월할 수 있나요?", chunks))
핵심은 시스템 프롬프트의 세 줄입니다. 문서 안에서만 답하기, 출처 표시, 애매하면 단정하지 않기. 환각 줄이기와 긴 문서 요령에서 다룬 원칙이 그대로 적용됩니다.
품질을 높이는 요령
- 검색 결과부터 확인: 답이 틀리면 대부분 검색 단계에서 엉뚱한 조각을 가져온 경우입니다. 생성보다 검색을 먼저 점검하세요.
- 테스트 질문 세트: 실제 들어오는 질문 30~50개와 정답을 만들어 두고, 설정을 바꿀 때마다 정답률을 확인합니다.
- "모름" 답변을 실패로 보지 않기: 문서에 없는 질문에 "찾을 수 없음"이라고 답하는 것은 정상 동작입니다. 오히려 지어낸 답이 더 위험합니다.
- 문서 최신화: 규정이 개정되면 색인도 바로 갱신해야 합니다. 개정일 메타데이터가 있으면 오래된 조각을 찾기 쉽습니다.
- 권한 관리: 부서별 열람 권한이 다른 문서는 검색 단계에서 사용자 권한에 맞게 걸러야 합니다.
단순하게 시작해 측정하며
RAG를 처음 공부할 때 벡터 데이터베이스, 임베딩 모델부터 알아봤는데, 막상 해 보니 문서 양이 많지 않으면 통째로 넣는 쪽이 더 정확했습니다. 기술 선택보다 중요한 건 "문서에 없으면 모른다고 답하게" 만드는 설계였습니다. 처음 만든다면 단순한 방식으로 시작해, 테스트 질문 세트로 측정하면서 필요한 만큼만 복잡하게 만들어 가세요.
이 글의 요점
- 문서가 적으면 통째로 넣고 캐싱, 많거나 자주 바뀌면 RAG(검색 후 생성)를 고려하세요.
- RAG는 문서 나누기 → 검색 → 조각을 근거로 답변 생성의 구조입니다.
- 문서 안에서만 답하기, 출처 표시, 검색 품질 점검, 테스트 질문 세트가 품질의 핵심입니다.