클로드 입력창 근처의 모델 선택 메뉴를 열어 보면 이름이 여러 개 보입니다. 처음에는 "뭐가 제일 좋은 거지?"라는 생각에 가장 비싼 모델만 골랐는데, 쓰다 보니 모든 작업에 큰 모델이 필요한 것은 아니라는 것을 알게 됐습니다.
이번 글에서는 클로드 모델 계열의 차이와, 제가 실제로 작업별로 모델을 고르는 기준을 정리합니다.
모델 이름의 규칙
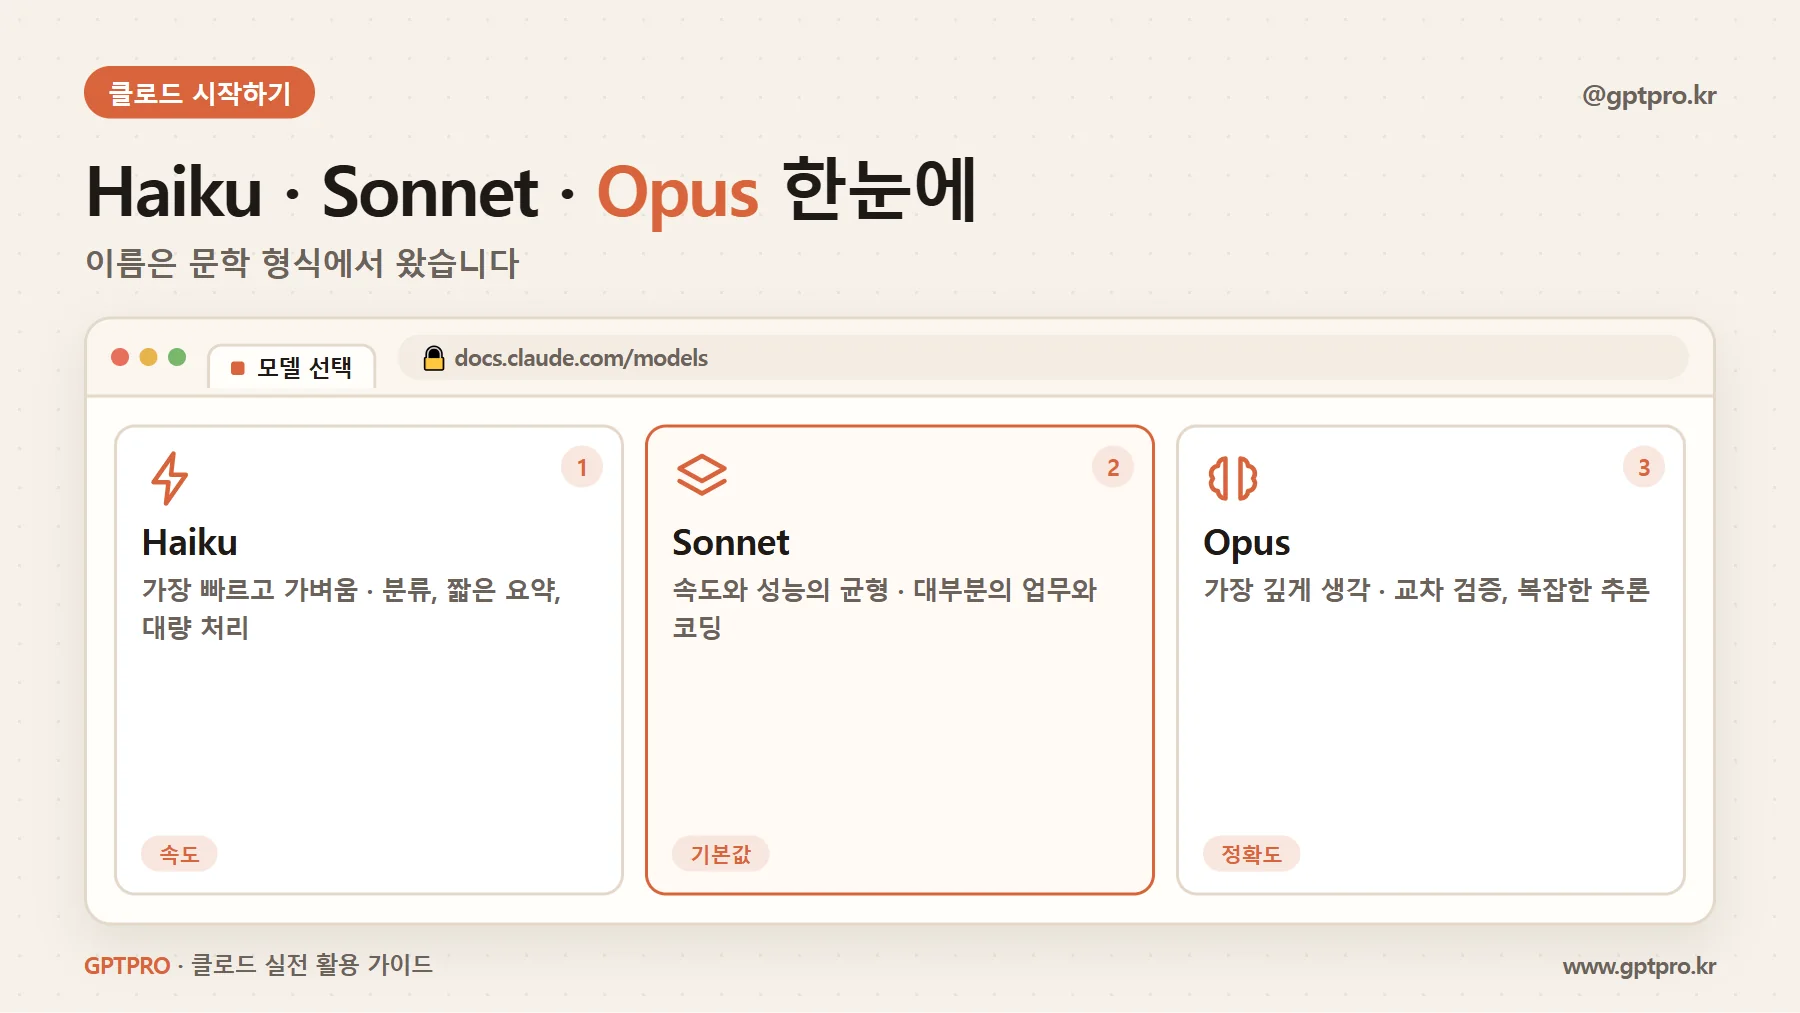
클로드 모델은 계열 이름 + 버전 번호로 구성됩니다.
- 계열 이름: Haiku, Sonnet, Opus — 크기와 성격을 나타냅니다.
- 버전 번호: 숫자가 클수록 최신 세대입니다. 같은 계열이라도 새 버전이 나오면 성능이 올라갑니다.
| 계열 | 이름의 뜻 | 성격 | 이럴 때 |
|---|---|---|---|
| Haiku | 3줄짜리 짧은 시 | 가장 빠르고 가벼움 | 분류, 짧은 요약, 대량 처리 |
| Sonnet | 14행 정형시 | 속도와 성능의 균형 | 대부분의 일상 업무, 코딩 |
| Opus | 대작 | 가장 깊게 생각함 | 복잡한 분석, 어려운 코딩, 긴 추론 |
이 밖에도 Anthropic은 특정 시기에 더 상위 등급 모델을 내놓기도 합니다. 새 모델이 나오면 공식 모델 개요 문서에서 위치를 확인하는 것이 가장 정확합니다.
같은 작업, 다른 모델로 해 본 결과
말로만 비교하면 감이 오지 않아서, 같은 요청을 모델별로 넣어 봤습니다.
작업 A: 고객 문의 메일 20개를 "환불/배송/기타"로 분류
- Haiku: 거의 즉시 끝났고, 분류도 정확했습니다.
- Sonnet·Opus: 결과는 같았지만 시간이 더 걸렸습니다.
→ 단순 분류는 가벼운 모델로 충분합니다. API로 대량 처리한다면 비용 차이도 큽니다.
작업 B: 회의록을 읽고 결정사항과 담당자 정리
- 세 모델 모두 무난했지만, Sonnet이 "결정된 것"과 "논의만 된 것"을 더 정확히 구분했습니다.
→ 일상 업무의 기본값은 Sonnet으로 두는 것이 무난합니다.
작업 C: 세 개 분기 보고서의 수치를 비교해 앞뒤가 안 맞는 부분 찾기
- Opus가 표 사이의 미묘한 불일치(분기 합계와 연간 합계 차이)를 찾아냈고, 다른 모델은 일부를 놓쳤습니다.
→ 여러 자료를 교차 검증하는 작업은 큰 모델을 쓸 가치가 있습니다.
대화창에서 모델 고르는 기준
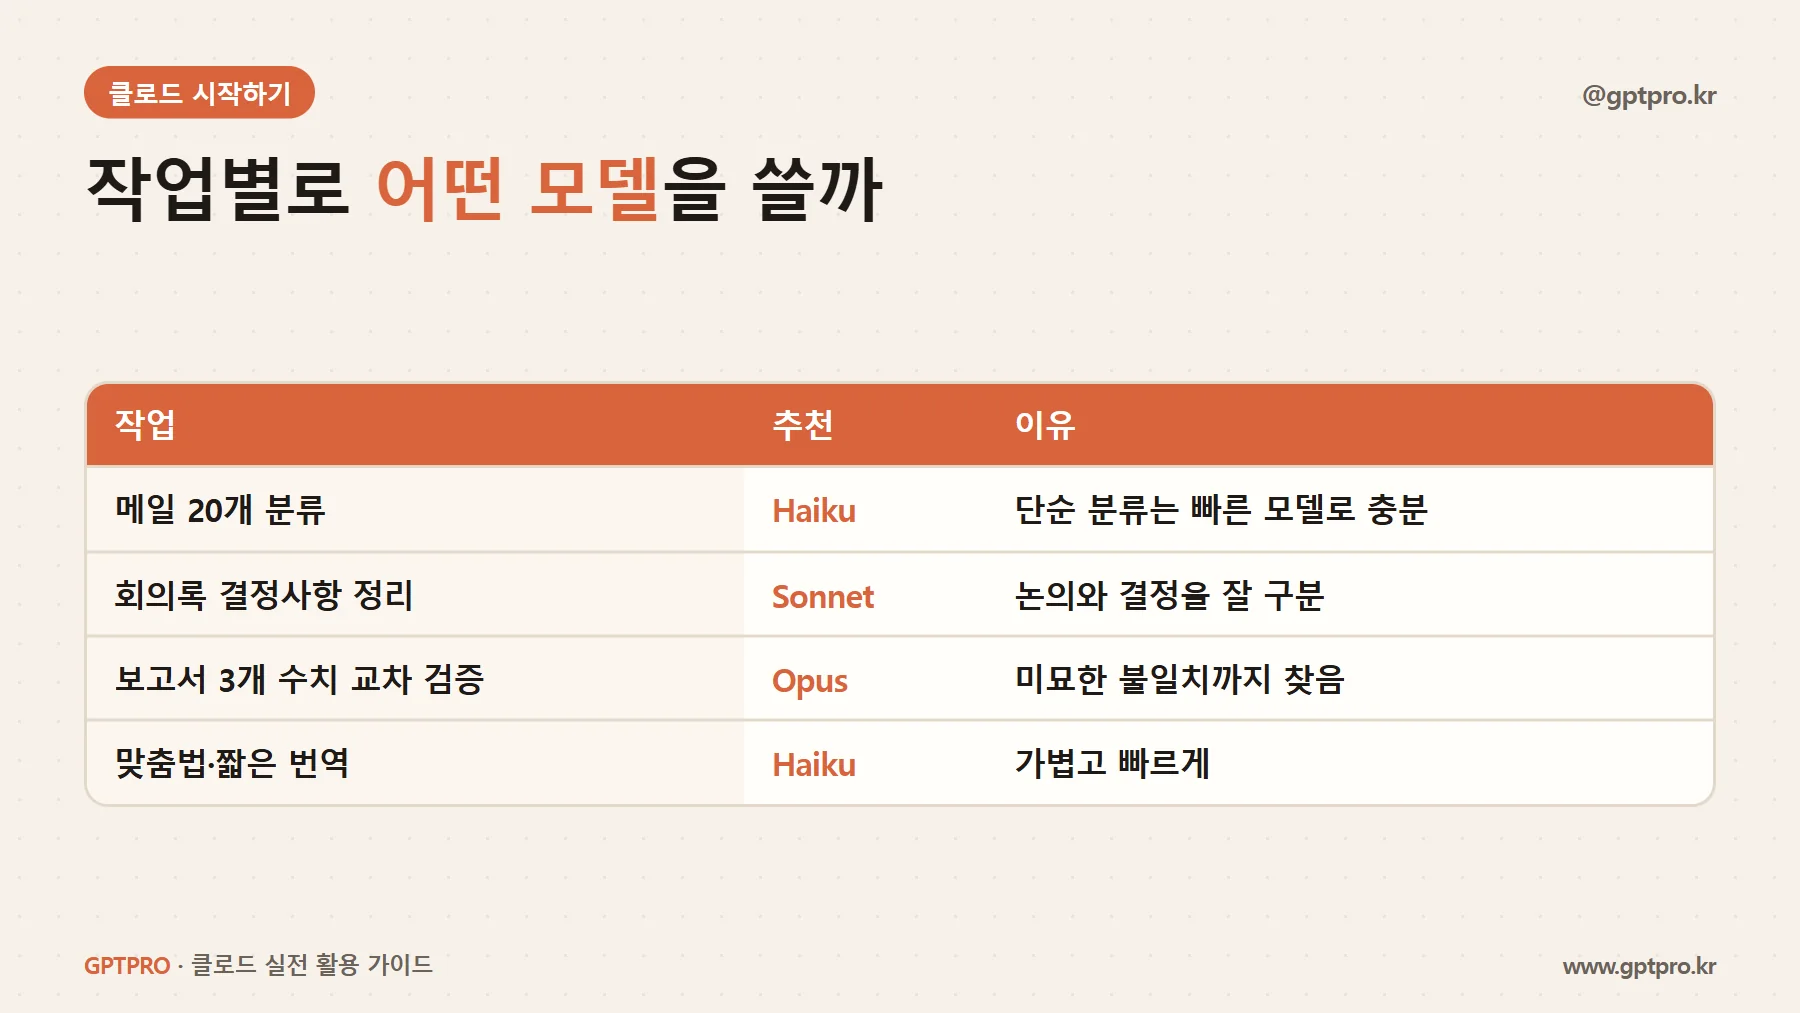
제가 쓰는 단순한 규칙은 이렇습니다.
- 기본은 Sonnet으로 둡니다.
- 답이 피상적이거나 조건을 자꾸 놓치면 Opus로 바꿔 같은 질문을 다시 합니다.
- 짧은 번역·맞춤법 확인처럼 단순 반복 작업은 Haiku로 빠르게 처리합니다.
유료 플랜에서도 큰 모델은 사용량을 더 많이 소모합니다. 하루 종일 Opus만 쓰면 한도에 빨리 도달하니, 어려운 질문에만 아껴 쓰는 것이 요령입니다.
API에서 모델 고르는 기준
API에서는 모델 선택이 곧 비용입니다. 모델마다 입력·출력 토큰당 가격이 다르고, 대체로 Haiku < Sonnet < Opus 순으로 비쌉니다.
| 상황 | 추천 출발점 |
|---|---|
| 하루 수천 건 분류·태깅 | Haiku |
| 챗봇, 문서 요약, 일반 코딩 | Sonnet |
| 에이전트, 복잡한 추론, 품질이 최우선 | Opus 또는 최상위 모델 |
API에서는 모델 이름을 정확한 모델 ID(예: claude-sonnet-5)로 지정합니다. 이 ID도 버전에 따라 바뀌므로 코드에 하드코딩하기보다 설정 파일로 빼 두는 것이 관리하기 편했습니다.
💬 모델보다 질문이 먼저입니다
모델을 고를 때 가장 흔한 실수는 "안 되면 큰 모델로 바꾸면 되겠지"라는 생각입니다. 실제로는 모델보다 질문을 바꾸는 쪽이 효과가 큰 경우가 많았습니다. 원하는 형식, 판단 기준, 예시를 질문에 넣고 나서도 결과가 부족할 때 모델을 올리는 순서를 추천합니다. 이 순서를 지키면 사용량도 아끼고 결과도 좋아집니다.
이 글의 요점
- Haiku는 빠르고 가볍게, Sonnet은 균형 있게, Opus는 깊게 생각하는 모델입니다.
- 일상 업무 기본값은 Sonnet, 교차 검증·복잡한 추론은 Opus, 대량 단순 작업은 Haiku가 효율적입니다.
- 결과가 부족하면 모델을 바꾸기 전에 질문부터 구체화해 보세요.